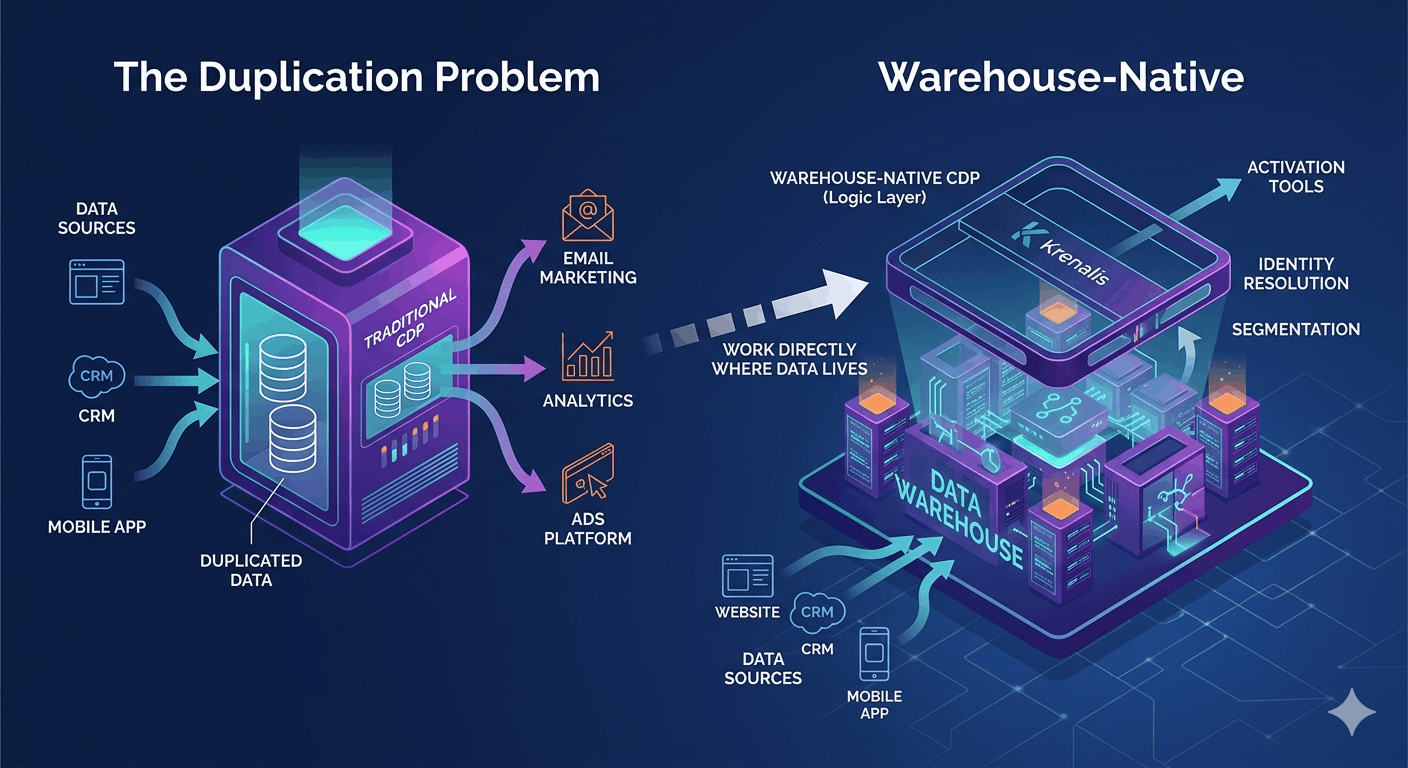
Quando si parla di Customer Data Platform, di solito si descrive un modello piuttosto standard: raccogliere dati da più sorgenti, inviarli al CDP, costruire profili cliente unificati e poi attivare quei dati negli strumenti marketing e di prodotto. Questo approccio è diventato la norma e, per molto tempo, ha funzionato bene.
Dietro questo modello, però, c'è un presupposto che viene raramente messo in discussione: per rendere utilizzabili i dati dei clienti, bisogna prima copiarli.
Perché la duplicazione è diventata la scelta predefinita
Osservando come sono costruiti i CDP tradizionali, l'architettura è piuttosto uniforme:
I dati vengono raccolti da siti web, app mobili, CRM e altri sistemi. Vengono poi acquisiti nel CDP, archiviati, elaborati e arricchiti. L'identity resolution avviene all'interno della piattaforma e i profili risultanti vengono inviati agli strumenti a valle.
Dal punto di vista del prodotto ha molto senso: permette al CDP di essere autonomo, semplifica l'onboarding e offre ai team un'interfaccia ordinata e unificata. Questa scelta introduce però anche una conseguenza strutturale: i dati dei clienti finiscono per risiedere in più di un luogo.
Che cosa significa davvero duplicare i dati
All'inizio, duplicare i dati potrebbe non sembrare un problema. Anzi, spesso appare comodo. Ma quando i sistemi crescono, iniziano a emergere gli effetti collaterali.
Potresti accorgerti che la stessa metrica assume valori leggermente diversi a seconda del sistema consultato, chiederti quale sia davvero la fonte attendibile o dover mantenere pipeline al solo scopo di allineare gli insiemi di dati.
Con il tempo, la duplicazione smette di essere un dettaglio implementativo e diventa parte dell'architettura. E quando entra nell'architettura, ha effetti su tutto:
* La governance diventa più complessa perché i dati sono distribuiti tra sistemi.
* Individuare gli errori diventa più difficile perché la logica è frammentata.
* Il carico operativo aumenta perché ogni copia deve essere mantenuta.
Nessuno di questi aspetti è necessariamente decisivo da solo, ma tutti sollevano una domanda:
Questa duplicazione è davvero necessaria?
Partire da un presupposto diverso
Un modo alternativo di affrontare il problema consiste nel partire da una premessa diversa.
Oggi, in molte aziende, il data warehouse contiene già la versione più completa e affidabile dei dati dei clienti: conserva eventi, transazioni, attributi degli utenti e spesso una parte rilevante della logica di business.
Se è così, copiare tutti quei dati in un altro sistema soltanto per elaborarli potrebbe non essere sempre la scelta migliore: anziché costruire un CDP che archivia i dati, si può pensare a un CDP che opera sui dati già disponibili.
Come funziona nella pratica
In un approccio warehouse-native il flusso è più semplice, almeno sul piano concettuale.
* Eventi e record alimentano il warehouse senza richiedere un archivio storico separato nel CDP.
* Gli eventi possono anche raggiungere direttamente le destinazioni in tempo reale.
Una volta che i dati sono lì, l'identity resolution diventa un problema di trasformazione.
Immagina, per esempio, un utente che prima visita il tuo sito in modo anonimo e poi effettua l'accesso.
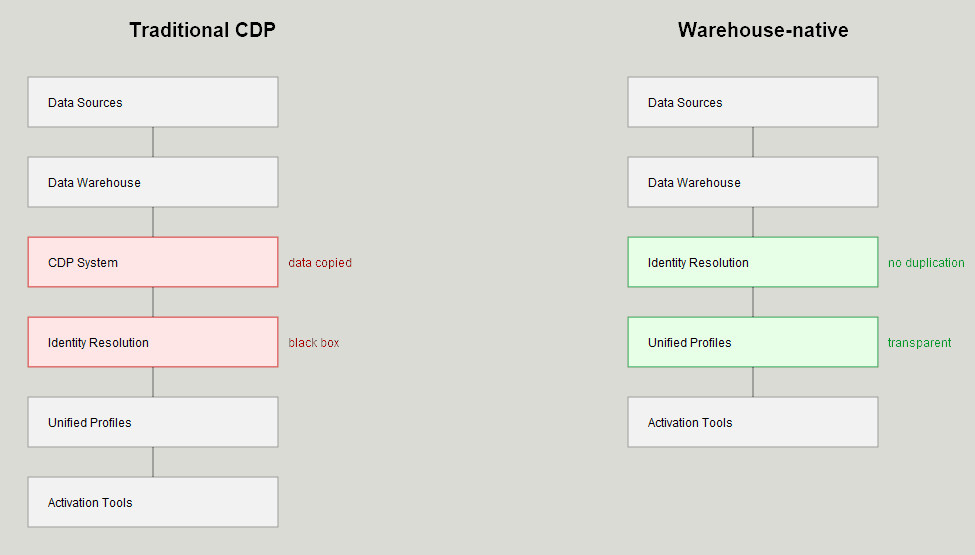
In un CDP tradizionale, la piattaforma gestirebbe l'unificazione al proprio interno.
In un modello warehouse-native, la logica di unificazione è esplicita: una tabella degli eventi può contenere campi come anonymous_id e user_id.
Un evento di accesso può collegare l'identificativo anonimo all'utente conosciuto e contribuire all'aggiornamento del profilo unificato.
La vista unificata può essere ottenuta attraverso trasformazioni SQL oppure gestita da una piattaforma come Krenalis, che applica gli identificatori e le priorità configurati.
La differenza importante non è il risultato.
In entrambi i casi si ottiene un profilo cliente unificato.
La differenza riguarda dove risiede la logica e quanto è visibile.
Rendere esplicita l'identity resolution
Uno degli effetti più interessanti di questo approccio è che l'identity resolution smette di essere una scatola nera.
Anziché rimanere nascosta in una piattaforma, diventa parte del modello dati: puoi esaminarla, versionarla e farla evolvere nel tempo.
Se qualcosa non torna, puoi risalire alle trasformazioni che lo hanno prodotto.
Se le regole di corrispondenza cambiano, puoi aggiornarle come qualsiasi altra parte del codice.
Questo non rende il problema più semplice, perché l'identity resolution è intrinsecamente complessa, ma lo rende più trasparente.
Costruire il profilo cliente nel warehouse
Una volta risolte le identità, la costruzione di un profilo cliente diventa un'estensione naturale dei flussi di lavoro sui dati.
Puoi aggregare eventi, calcolare metriche e definire segmenti direttamente nel warehouse.
Per esempio, potresti calcolare:
- quando un utente è stato rilevato per la prima volta
- con quale frequenza interagisce con il prodotto
- se ha effettuato un acquisto
Tutte queste informazioni risiedono in tabelle accessibili al resto dell'organizzazione.
I team di analisi, prodotto e marketing possono lavorare sullo stesso insieme di dati, senza dover riconciliare sistemi diversi.
Attivare i dati senza continui trasferimenti
Anche l'attivazione cambia leggermente: invece di estrarre i dati dal database di un CDP, puoi inviarli direttamente dal warehouse agli strumenti che ne hanno bisogno.
In alcuni casi, gli strumenti possono persino leggere direttamente dal warehouse.
Anche qui, l'obiettivo non è eliminare funzionalità, ma ridurre il numero di passaggi e di sistemi coinvolti.
I compromessi da considerare
Questo approccio non è però una scorciatoia: pur eliminando un livello di complessità, ne introduce un altro.
- Le prestazioni sono uno dei primi aspetti da considerare: eseguire l'identity resolution su grandi insiemi di dati può richiedere molta capacità di calcolo, soprattutto quando i volumi aumentano.
- Anche i costi cambiano: non paghi più per archiviare dati duplicati all'interno di un CDP, ma potresti consumare più risorse di calcolo del warehouse.
- I casi d'uso in tempo reale richiedono una progettazione attenta: mentre i CDP tradizionali sono spesso ottimizzati per aggiornamenti immediati, gli approcci basati sul warehouse possono affidarsi a micro-batch o pipeline di streaming.
- Il team mantiene il controllo sulle regole di unificazione, mentre la piattaforma può gestirne l'esecuzione e l'aggiornamento dei profili. Il livello di competenza tecnica richiesto dipende dalla soluzione adottata.
Quando questo modello ha senso
Questo modo di costruire un CDP tende a funzionare bene nelle organizzazioni che dispongono già di solide fondamenta per i dati.
Se il warehouse è centrale nella tua architettura e il team ha familiarità con modelli dati e trasformazioni, i vantaggi possono essere significativi.
È il principio alla base dell'approccio warehouse-native di Krenalis: ridurre la duplicazione e mantenere la logica vicino ai dati.
Un cambio di prospettiva
A rendere interessante questo approccio non sono soltanto le differenze tecniche.
Esprime un cambiamento più ampio nell'evoluzione dei sistemi dati: invece di costruire strumenti che detengono e replicano i dati, sempre più sistemi iniziano a operare direttamente sui livelli dati esistenti.
In questo contesto, il ruolo di un CDP cambia: conta meno l'archiviazione dei dati e conta di più mettere i team nelle condizioni di utilizzarli in modo efficace.
Considerazioni finali
Non esiste un unico modo corretto di costruire un CDP.
Esistono architetture diverse perché i problemi da risolvere sono diversi.
Tuttavia, se il tuo data warehouse contiene già i dati dei clienti più completi e affidabili, vale la pena porsi una domanda semplice.
Devi davvero copiarli altrove per renderli utili?
Oppure puoi lavorare direttamente dove risiedono già?
Se stai esplorando approcci simili o hai affrontato questi compromessi nella pratica, ci interessa conoscere il tuo punto di vista.
Parliamo della tua architettura dati
Passare a un approccio warehouse-native comporta scelte sia ingegneristiche sia strategiche. Che tu voglia ottimizzare la configurazione attuale, ridurre la duplicazione dei dati o costruire un'infrastruttura dei dati dei clienti più trasparente, siamo qui per aiutarti a individuare il percorso più adatto.
Contatta il team Krenalis per condividere le tue esigenze o discutere di come rendere il data warehouse il vero motore della tua crescita.