La maggior parte delle discussioni sulle Customer Data Platform (CDP) che vedo parte dalle funzionalità: connettori, strumenti per creare audience, identity resolution, eventi in tempo reale e reverse ETL. Ma la domanda più difficile si colloca solitamente un livello sotto l'elenco delle funzionalità: dove dovrebbe risiedere davvero il profilo cliente?
Immagina un assistente IA che prepara un suggerimento sulla prossima azione più efficace per un commerciale. Può consultare segnali provenienti da CRM, fatturazione, utilizzo del prodotto e warehouse, ma quei sistemi potrebbero non concordare su ciò che il cliente sta facendo o sullo stato effettivo del suo account. Prima che l'assistente possa formulare un consiglio utile, l'azienda deve decidere quale profilo cliente considerare attendibile e dove costruirlo.
È questo il requisito fondamentale alla base di molti casi d'uso dell'IA nel marketing, nelle vendite e nel customer success: una visione affidabile del cliente.
Che si tratti di un assistente che suggerisce la prossima azione a un commerciale, di un flusso che assegna la priorità agli account a rischio o di una campagna che adatta il messaggio all'utilizzo del prodotto, l'esigenza di fondo è la stessa. Bisogna sapere chi è il cliente, che cosa ha fatto, quali sistemi possiedono informazioni su di lui e quale versione di quelle informazioni sia attendibile.
Sembra ovvio, finché non si osserva come sono distribuiti i dati dei clienti in un'azienda. Il CRM può contenere i dettagli di contatti e account, la fatturazione può conoscere piano e cronologia dei pagamenti, il database di prodotto può conservare utenti ed eventi, mentre assistenza, email e strumenti di analisi mantengono ciascuno una vista utile ma parziale. Da qualche parte può esserci anche un data warehouse, nel quale alcuni o tutti questi segnali vengono copiati, modellati e analizzati.
A quel punto, «il cliente» non è un singolo record. Assomiglia piuttosto a un sistema distribuito: è proprio il tipo di problema per cui sono nate le Customer Data Platform.
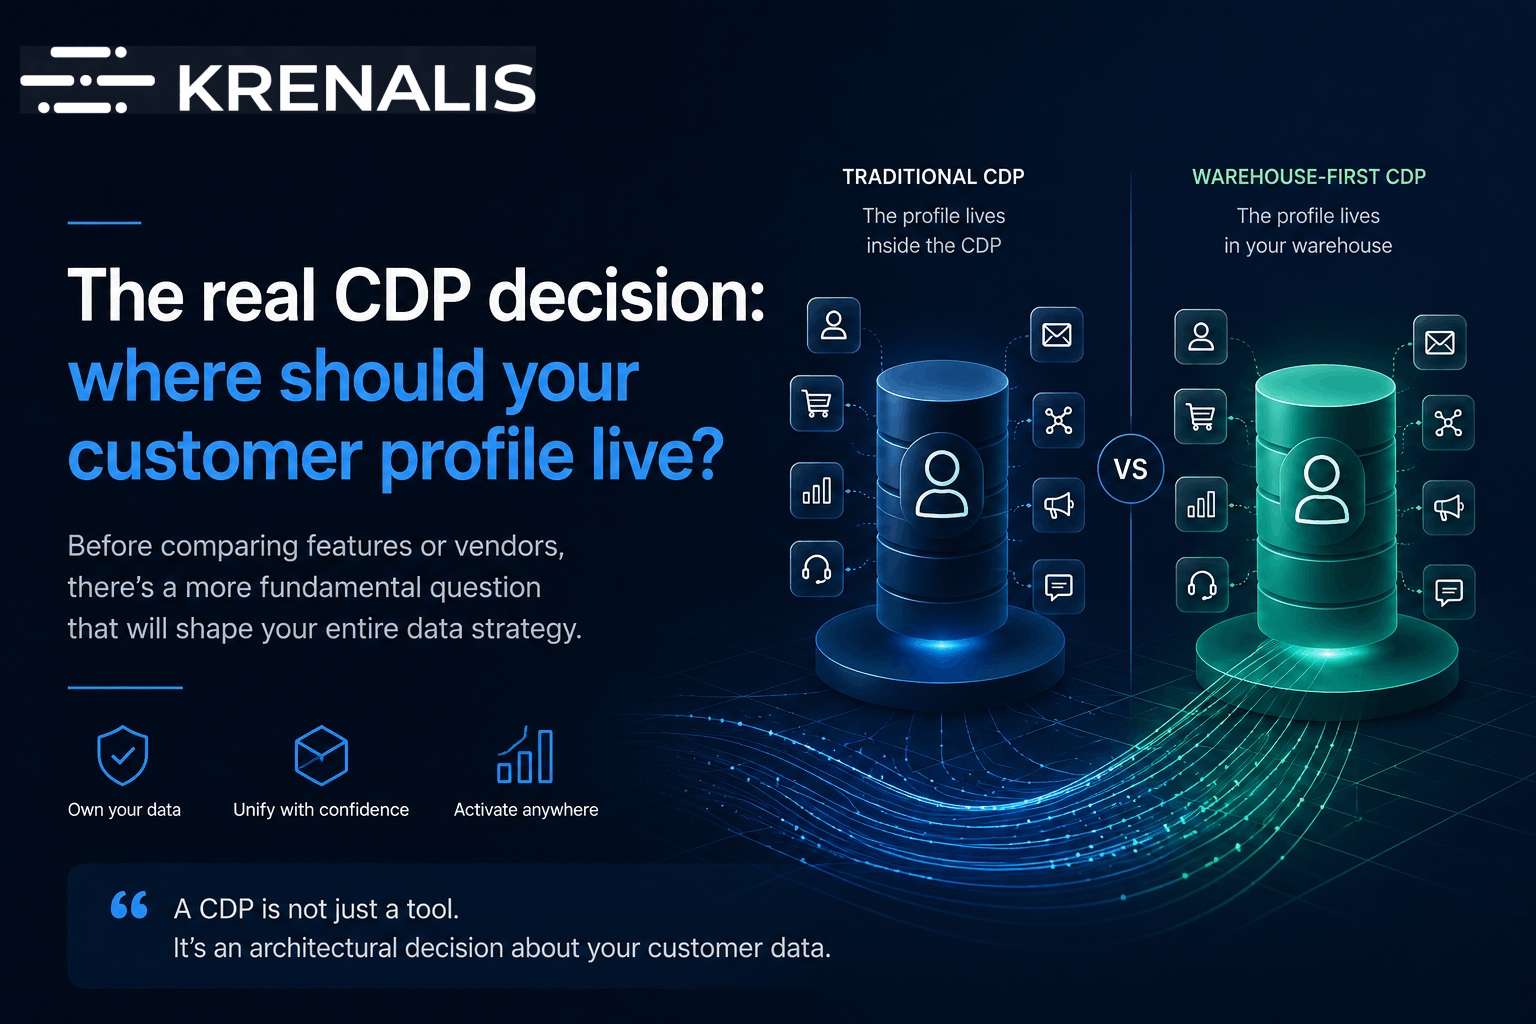
La vera scelta sul CDP non riguarda soltanto lo strumento con i migliori connettori o le migliori funzioni per creare audience. Riguarda il luogo in cui dovrebbe risiedere il profilo cliente.
Che cosa fa davvero un CDP
Una Customer Data Platform, o CDP, è un sistema che raccoglie dati dei clienti da sorgenti diverse, collega record e identificativi appartenenti alla stessa persona o allo stesso account, costruisce profili e segmenti di clientela e rende quei profili disponibili ad altri strumenti.
Nella pratica, la maggior parte dei CDP svolge quattro grandi compiti: raccogliere dati, risolvere identità, costruire profili o audience e attivare quelle audience nei sistemi a valle, come CRM, strumenti email, piattaforme pubblicitarie, strumenti di assistenza o piattaforme per il coinvolgimento degli utenti nel prodotto.
Per esempio, un CDP può ricevere un evento web anonimo, collegarlo in seguito a un utente autenticato, arricchire quell'utente con dati del CRM e della fatturazione, inserirlo in un segmento e sincronizzare il segmento con uno strumento di marketing automation.
Il valore è facile da comprendere. Anziché lasciare che ogni strumento mantenga la propria visione parziale del cliente, l'azienda ottiene un profilo più coerente, utilizzabile dai diversi team.
La domanda importante non è se questo sia utile: di solito lo è. La domanda più importante è dove dovrebbe risiedere questo profilo.
Il modello tradizionale: il CDP al centro
I CDP tradizionali risolvono il problema creando una piattaforma specializzata con una propria archiviazione, un proprio modello dati, una propria logica di identity resolution, un motore di segmentazione e connettori per l'attivazione.
L'architettura è, in sintesi, questa:
Sorgenti → Database del CDP → Profili cliente / segmenti → Destinazioni
Questo modello aveva molto senso, soprattutto quando molte aziende non disponevano di un data warehouse maturo o di un team dati capace di costruire e mantenere internamente questa infrastruttura. Un CDP tradizionale offriva ai team marketing e growth un ambiente pronto per raccogliere eventi, unificare identità, creare audience e inviare dati ad altri strumenti, senza aspettare mesi per una piattaforma dati su misura.
Va detto chiaramente: i CDP tradizionali hanno risolto un problema reale. Hanno reso i dati dei clienti utilizzabili nei processi operativi, oltre che nelle analisi. Hanno dato ai team non tecnici un modo per lavorare con informazioni che altrimenti sarebbero rimaste bloccate in database, log, esportazioni o richieste in attesa nel backlog del team dati.
Il compromesso riguarda l'architettura.
Un CDP tradizionale diventa spesso un ulteriore luogo in cui risiedono i dati dei clienti. I dati vengono copiati dai sistemi sorgente nel CDP, che costruisce una propria rappresentazione del cliente. Questa rappresentazione può poi convivere con un'altra nel data warehouse, un'altra nel CRM e diverse versioni parziali negli strumenti a valle.
Può funzionare, ma introduce problemi noti: duplicazione, logiche di sincronizzazione, possibili incoerenze, dipendenza dal fornitore e governance distribuita su più sistemi. Se il CDP indica un abbonamento come attivo e il warehouse lo riporta come cessato, quale informazione dovrebbe utilizzare un assistente IA?
Non sono soltanto domande teoriche. Diventano concrete non appena i dati dei clienti iniziano a guidare decisioni automatizzate.
Perché l'approccio warehouse-first ha cambiato la discussione
L'approccio warehouse-first nasce da un contesto diverso.
Oggi, in molte aziende, il data warehouse non è più soltanto il luogo delle dashboard e dei report mensili. È il punto in cui si combinano eventi di prodotto, dati di CRM, fatturazione, assistenza, marketing e amministrazione. Che lo stack sia basato su Snowflake, BigQuery, Redshift, Databricks o altro, il warehouse è spesso ciò che più si avvicina a una base dati aziendale soggetta a una governance comune.
A quel punto la discussione sul CDP cambia. Se il warehouse è già il luogo in cui l'azienda combina e governa i propri dati, è ragionevole chiedersi perché il profilo cliente di riferimento debba risiedere altrove.
Un CDP warehouse-first parte da questa premessa. Anziché mettere al centro il database del fornitore del CDP, mette al centro il warehouse dell'azienda cliente.
L'architettura si avvicina quindi a questa:
Sorgenti → Warehouse dell'azienda → Profili cliente / segmenti → Destinazioni
Il CDP conserva un ruolo preciso. Può occuparsi di acquisizione dei dati, identity resolution, costruzione dei profili, gestione delle audience, reverse ETL o processi di interazione con i clienti. La differenza fondamentale è che il profilo viene costruito nell'ambiente dati dell'azienda cliente, anziché in un silo proprietario esterno.
Per sviluppatori e team dati è questo l'aspetto decisivo. Il warehouse può essere interrogato ed esaminato. I modelli possono essere versionati. La provenienza e le trasformazioni dei dati possono essere comprese. Il controllo degli accessi può seguire le politiche esistenti. Profili e segmenti possono essere riutilizzati da analisi, prodotto, amministrazione, customer success e flussi IA, oltre che dagli strumenti marketing.
L'approccio warehouse-first non è sempre migliore, ma allinea il CDP al luogo in cui molte aziende gestiscono già i propri asset informativi più importanti.
Warehouse-first non identifica una sola architettura
Una parte della confusione nasce dal fatto che «CDP warehouse-first» non descrive un'unica architettura. È una famiglia di approcci.
Alcuni strumenti si basano soprattutto sulla lettura dei dati dove si trovano già. Si collegano alle tabelle esistenti nel warehouse, permettono agli utenti di definire audience o mappature e materializzano soltanto i risultati necessari per l'attivazione.
Altri strumenti sono più vicini alle piattaforme di reverse ETL. Presuppongono che il warehouse contenga già tabelle clienti, attributi e segmenti correttamente preparati e si concentrano sulla sincronizzazione di quei record con applicazioni SaaS come Salesforce, HubSpot, Braze, Customer.io, Intercom o piattaforme pubblicitarie.
Altri sistemi adottano un approccio più gestito. Raccolgono eventi, importano identità e attributi dagli strumenti SaaS e normalizzano tutto in uno schema CDP di riferimento all'interno del warehouse dell'azienda cliente. Su quello schema eseguono l'identity resolution, costruiscono profili unificati e attivano i profili nei sistemi a valle.
Quest'ultimo modello è importante perché si colloca tra un approccio puro in cui l'azienda fornisce tabelle già modellate e un CDP tradizionale. Crea effettivamente tabelle normalizzate e, in alcuni casi, questo significa duplicare dati già presenti nel warehouse. Ma la copia risiede nel warehouse dell'azienda cliente, segue uno schema che l'azienda può esaminare e controllare e diventa parte della sua architettura dati, anziché una scatola nera del fornitore del CDP.
È un dettaglio architetturale apparentemente piccolo, con un grande impatto pratico.
La duplicazione non è il vero punto
I CDP warehouse-first vengono spesso descritti come un modo per evitare la duplicazione dei dati. Il concetto è sostanzialmente corretto rispetto a un CDP tradizionale che conserva un altro database clienti al di fuori del warehouse, ma può anche risultare fuorviante.
Una certa duplicazione è inevitabile. Se i dati dei clienti risiedono in strumenti SaaS e vuoi combinarli con utilizzo del prodotto, fatturazione, assistenza e marketing, di solito devi copiarli in un ambiente comune. Se i dati sono già nel warehouse, può comunque essere utile normalizzarli in uno schema condiviso per risolvere le identità, costruire i profili e attivarli.
La vera distinzione, quindi, non è «duplicazione o assenza di duplicazione». Le domande più utili sono: chi controlla la duplicazione, dove avviene e a quale scopo?
In un CDP tradizionale, il profilo cliente normalizzato risiede spesso nella piattaforma del fornitore. In un modello warehouse-first, ogni materializzazione necessaria avviene nel warehouse dell'azienda cliente. Questo non elimina ogni copia, ma evita di creare un silo proprietario separato per i dati dei clienti.
Per un pubblico tecnico, è il modo più corretto di inquadrare il tema. L'approccio warehouse-first non è una soluzione magica. È una scelta architetturale: se profili cliente, identità e segmenti sono asset strategici, vanno costruiti dove l'azienda può interrogarli, governarli, riutilizzarli e cambiare fornitore senza perdere le fondamenta del proprio lavoro sui dati dei clienti.
L'IA alza la posta in gioco
L'IA rende questa discussione più difficile da ignorare, perché accresce le esigenze di qualità e coerenza del contesto relativo ai clienti.
Se i sistemi IA devono riepilogare account, suggerire azioni, personalizzare messaggi, classificare utenti, rilevare il rischio di abbandono o aggiornare record del CRM, hanno bisogno di contesto sul cliente. Quel contesto non può essere un insieme casuale di attributi obsoleti, identificativi in conflitto e record parziali provenienti da strumenti scollegati.
Anche un CDP tradizionale può supportare casi d'uso dell'IA. Non è questo il punto. Ma il modello warehouse-first è spesso più naturale quando l'IA richiede un contesto trasversale: utilizzo del prodotto, ricavi, assistenza, ciclo di vita, consensi, gerarchia degli account e cronologia operativa. Questi segnali spesso esistono già, o dovrebbero esistere, nel warehouse.
In questo senso, l'IA non sostituisce il bisogno di un CDP. Alza l'asticella di ciò che il livello sottostante dei dati dei clienti deve fornire.
Scegliere un CDP significa scegliere un'architettura
Il confronto tra CDP tradizionali e CDP warehouse-first viene talvolta presentato come un confronto tra funzionalità: connettori, strumenti per creare audience, eventi in tempo reale, identity resolution, reverse ETL e così via. Queste funzioni contano, ma non sono la scelta che determina l'architettura.
La questione centrale è dove dovrebbe risiedere il profilo cliente. Un CDP tradizionale lo costruisce nella propria piattaforma e lo attiva da lì; un CDP warehouse-first lo costruisce nel warehouse dell'azienda cliente e utilizza il livello CDP per renderlo operativo.
Entrambi gli approcci possono essere validi, a seconda della maturità dell'azienda, della struttura dei team, dei casi d'uso e dell'urgenza. Un team marketing senza un data warehouse maturo può ottenere valore più rapidamente da un CDP tradizionale. Un'azienda con un warehouse solido, un team dati e casi d'uso più ampi tra prodotto, vendite, customer success e IA può preferire di mantenere il profilo cliente vicino alle proprie fondamenta dati esistenti.
Questo compromesso dovrebbe essere esplicito fin dall'inizio. Un CDP non è soltanto uno strumento per inviare audience ad altri strumenti. È una decisione sull'architettura dei dati dei clienti.
Quando i dati dei clienti iniziano ad alimentare automazioni e IA, questa decisione smette di essere un semplice dettaglio implementativo.