Le Customer Data Platform sono nate con una promessa ambiziosa: riconoscere lo stesso cliente nei diversi sistemi.
I dati dei clienti erano, e sono tuttora, distribuiti tra strumenti, canali e dispositivi. La stessa persona compare più volte, con identificativi diversi, senza un modo affidabile per collegarli.
I team marketing faticano a personalizzare le comunicazioni, i team di analisi lavorano su dati incompleti e ogni decisione, in qualche misura, poggia su questa frammentazione.
I CDP sono intervenuti promettendo: «Unificheremo i dati dei vostri clienti», ma risolvendo un problema ne hanno introdotto un altro, in modo quasi impercettibile.
Il compromesso
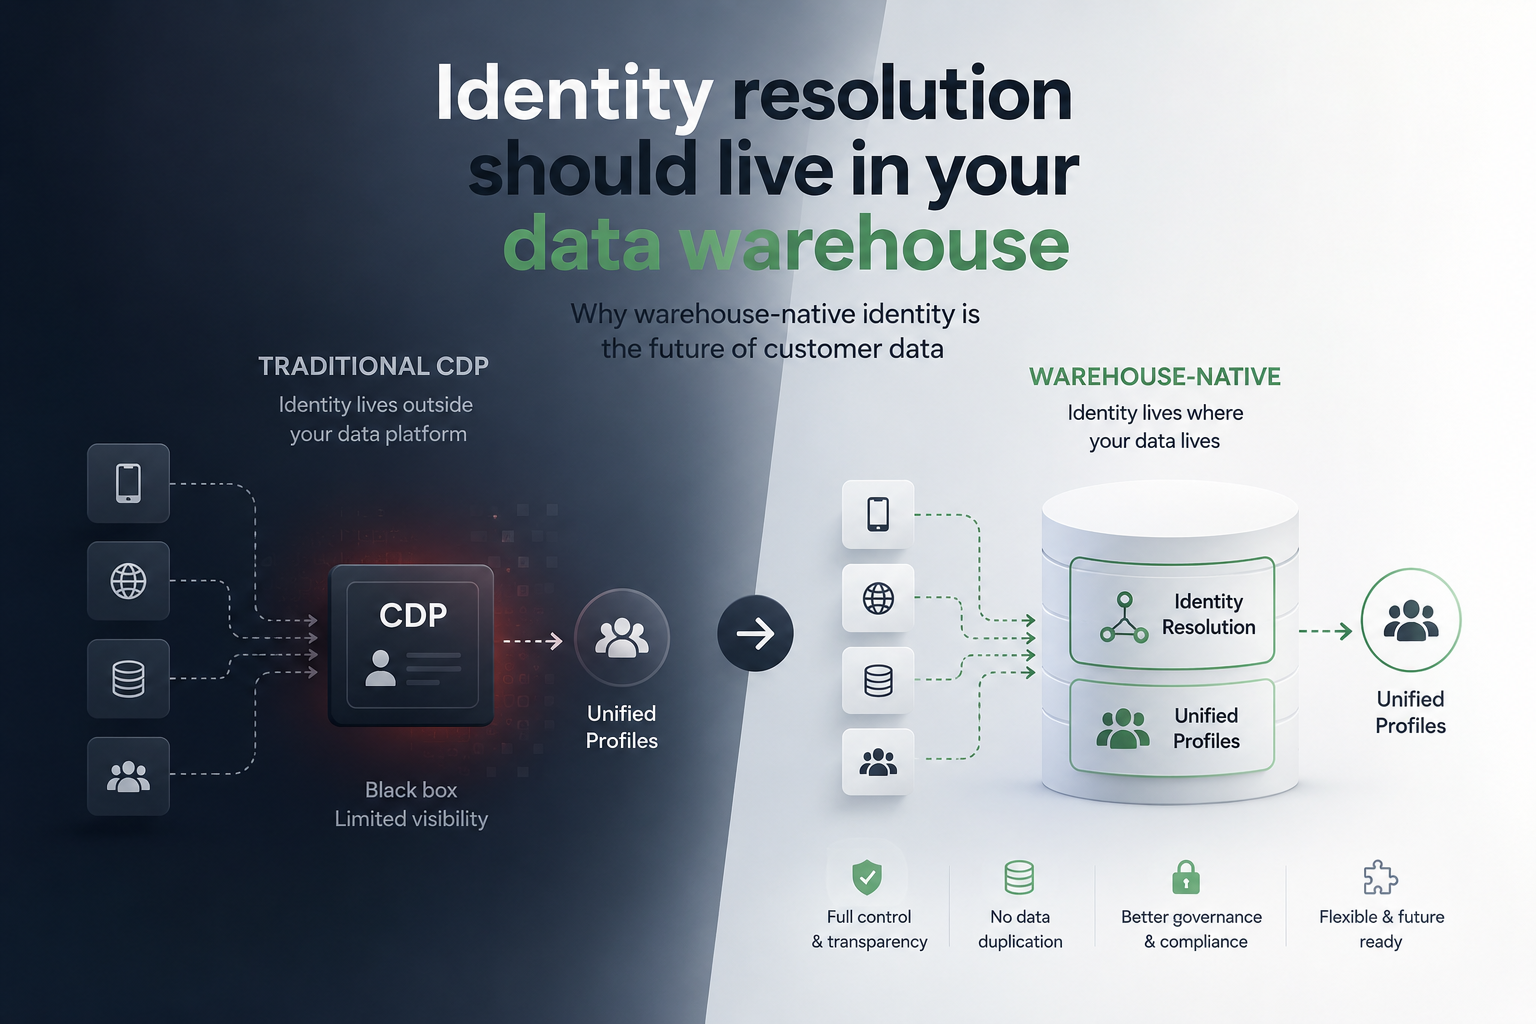
La maggior parte dei CDP realizza l'identity resolution all'interno del proprio ambiente.
A prima vista ha perfettamente senso: Invii i dati al CDP, che li elabora, risolve le identità e restituisce profili unificati.
Semplice, ordinato e centralizzato.
Questa semplicità comporta però un compromesso: per far funzionare il sistema, i dati vengono acquisiti da più sorgenti e trasferiti nell'ambiente del CDP.
Lì vengono trasformati, archiviati e resi disponibili per l'attivazione.
A quel punto avviene un cambiamento meno evidente. La logica che determina l'identità dei clienti, una delle parti più importanti della tua strategia sui dati, non risiede più nella tua piattaforma dati.
Si trova altrove.
Quando l'identità diventa una scatola nera
All'inizio non sembra un problema perché il CDP funziona, i profili vengono creati e le campagne avviate.
Con il tempo, però, emergono alcune domande:
«Come è stato costruito esattamente questo profilo?»
«Perché questi due record sono stati attribuiti alla stessa persona?»
«Possiamo modificare le regole di corrispondenza?»
«Possiamo riutilizzare questo modello di identità altrove?»
E trovare le risposte non è sempre semplice.
Perché, in questo modello, l'identità non è più del tutto trasparente.
Viene gestita in un sistema che affianca la tua piattaforma dati, anziché farne parte.
Anche se la tua azienda ha investito molto in uno stack dati moderno,
una parte fondamentale della logica sui dati viene di fatto affidata a un ambiente esterno.
Un nuovo tipo di silo
Questo porta a un risultato inatteso.
I CDP avrebbero dovuto eliminare i silos, ma in molti casi ne hanno creato uno nuovo: più evoluto, ma pur sempre un silo.
Ti ritrovi quindi con:
- una piattaforma dati che contiene i dati grezzi e quelli modellati
- un CDP in cui vengono risolte le identità
- una separazione crescente tra i due ambienti
Ogni volta che devi esaminare, modificare o estendere la logica di identità,
devi uscire dal tuo ambiente dati principale.
E questo crea attriti, sia tecnici sia organizzativi.
Ripensare dove dovrebbe risiedere l'identità
Considera ora un approccio diverso.
E se l'identity resolution non avvenisse in un sistema separato?
Se risiedesse direttamente nel tuo data warehouse?
Senza trasferire i dati in ambienti esterni, duplicare la logica né perdere visibilità.
In un modello warehouse-native, l'identity resolution viene eseguita dove i dati risiedono già.
I profili unificati vengono costruiti lì.
Le trasformazioni sono trasparenti, interrogabili e interamente sotto il tuo controllo.
Il tuo team dati può esaminare la logica, farla evolvere e integrarla con gli altri modelli, proprio come qualsiasi altro componente dello stack dati.
L'identità smette di essere una funzionalità del prodotto e diventa una componente fondamentale della tua infrastruttura dati.
Perché questo cambiamento conta
Non si tratta soltanto di una preferenza tecnica. Cambia il modo in cui i team lavorano con i dati.
Quando l'identità risiede nel warehouse, non devi riconciliare più sistemi né chiederti dove si trovi la versione «reale» di un profilo.
Mantieni il controllo.
Riduci la complessità superflua.
Applichi la governance dove è già presente.
E, forse soprattutto, guadagni flessibilità.
Perché l'identità non è più vincolata ai confini di uno strumento.
Può evolvere insieme ai tuoi dati, ai tuoi modelli e alle esigenze della tua azienda.
L'identità è un problema di dati
Uno degli equivoci più diffusi nel mondo dei CDP è considerare l'identity resolution una semplice funzionalità.
Qualcosa che uno strumento mette a disposizione e che basta «attivare».
Ma l'identità non è una semplice funzionalità.
È un problema di modellazione, infrastruttura, titolarità e controllo dei dati.
E questi problemi non dovrebbero essere relegati a un sistema esterno.
Dovrebbero essere affrontati dove risiedono i tuoi dati.
Una visione diversa dei CDP
Questo non significa che i CDP siano superati, ma che devono evolvere.
Il futuro dei CDP non è un'altra piattaforma che prende il controllo dei tuoi dati.
È un livello che lavora con l'infrastruttura che già possiedi.
Un livello che collega le sorgenti, risolve le identità e costruisce profili unificati,
senza diventare il sistema in cui risiede il dato di riferimento.
La domanda conclusiva non è più: «Hai un CDP?»
Ma una domanda molto più fondamentale:
«Dove risiede davvero l'identità dei tuoi clienti?»
Perché è lì che risiedono anche il tuo controllo e il tuo vantaggio nel lungo periodo.