Nel primo articolo della serie abbiamo esaminato una difficoltà che emerge in molti progetti di Customer AI: prima di utilizzare le informazioni sui clienti, un'applicazione deve poter ricostruire a chi si riferiscono e quale contesto descrivono. Collegare CRM, fatturazione, assistenza e prodotto rende disponibili molti dati, ma la loro utilità dipende anche dal modo in cui vengono organizzati e collegati.
Il passo successivo consiste nel definire che cosa debba contenere un profilo cliente destinato all'IA. CRM e CDP hanno già i propri profili, così come gli strumenti di marketing, assistenza e analisi del prodotto. Per impiegarli in un processo automatizzato occorre però chiarire come siano state collegate le identità, quali informazioni siano attuali e quali utilizzi siano consentiti. Un profilo pronto per l'IA deve rendere queste condizioni comprensibili e verificabili.
Questo lavoro riguarda insieme la raccolta di eventi e record, l'identity resolution, la qualità dei dati e le modalità con cui le applicazioni ricevono il contesto. L'obiettivo è costruire una rappresentazione del cliente che possa essere aggiornata, esaminata e adattata ai diversi casi d'uso, mantenendo il collegamento con le informazioni originali.
Un profilo cliente non è un contenitore indiscriminato di dati
Riunire in un unico oggetto tutto ciò che l'azienda sa di una persona o di un'organizzazione può sembrare un buon modo per aiutare l'IA a decidere che cosa sia rilevante. In realtà, eventi, campi del CRM, note di assistenza e record di fatturazione hanno significati e finalità differenti. Presentarli insieme senza una struttura lascia all'applicazione il compito di interpretare relazioni e differenze che dovrebbero essere definite nell'architettura dei dati.
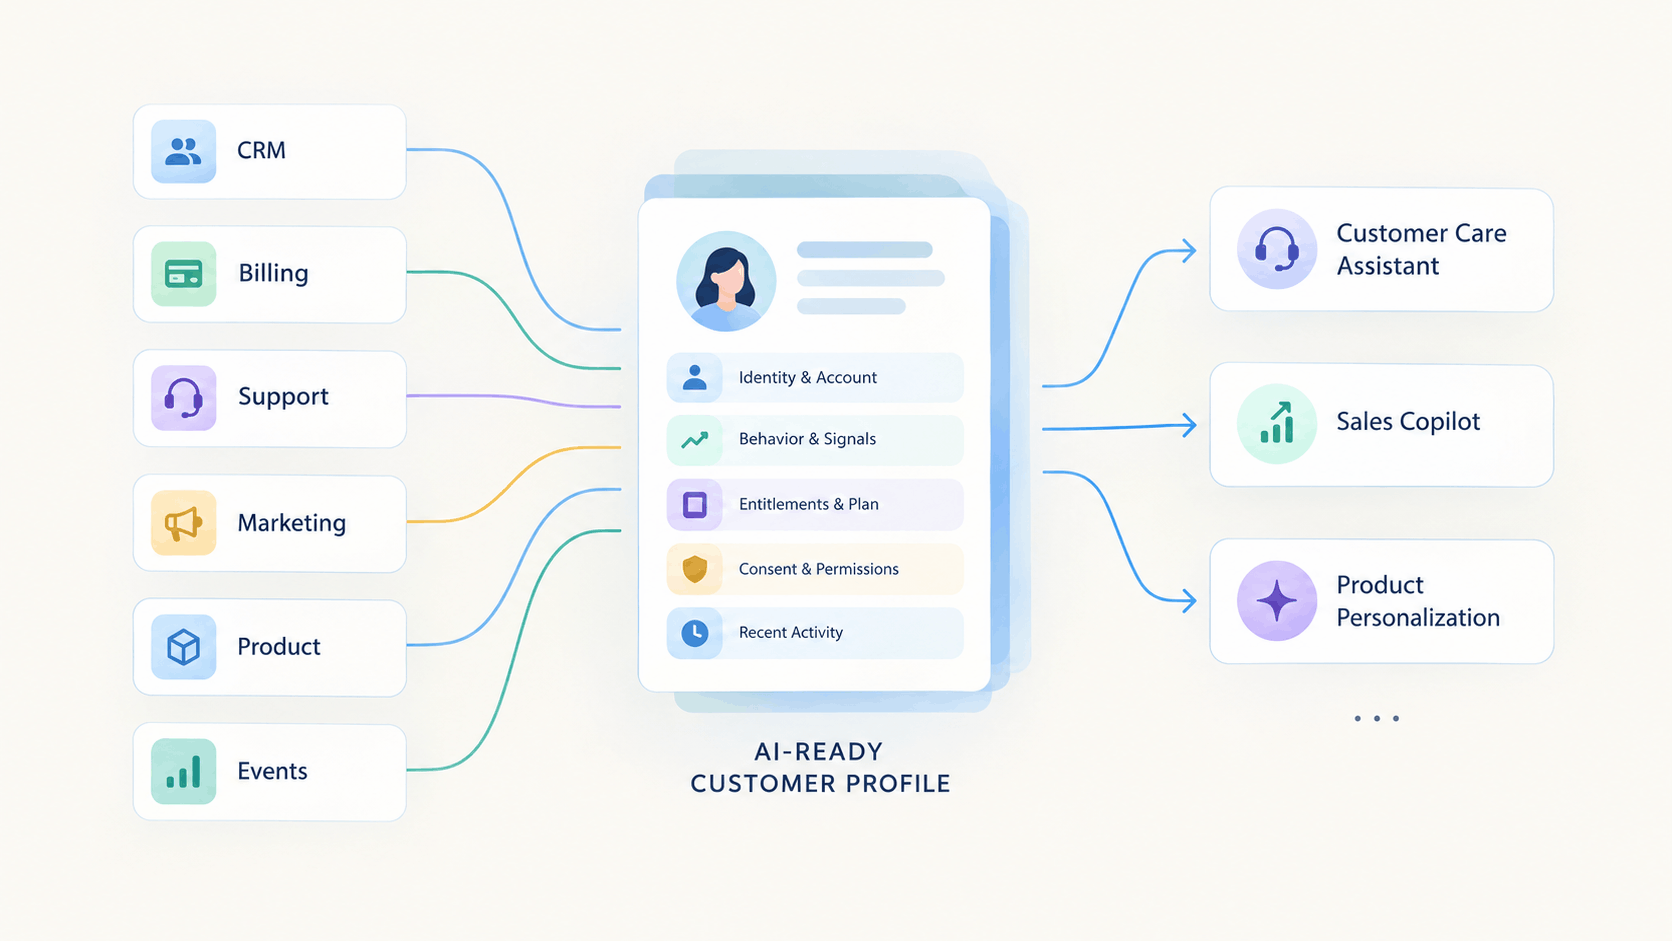
Un assistente per il servizio clienti, per esempio, può aver bisogno di sapere che ci sono tre ticket aperti, che l'ultimo è critico, che l'account ha un piano enterprise e che si sono verificati ripetuti errori di accesso. Per quella richiesta potrebbero essere irrilevanti le pagine visitate, i clic sulle email, le campagne o le note commerciali accumulate nei due anni precedenti. Un assistente alle vendite potrebbe invece avere bisogno del valore del contratto, della data di rinnovo, del responsabile dell'account e dei segnali recenti di adozione del prodotto.
Le informazioni originali devono rimanere tracciabili, con gli eventi che descrivono la cronologia, i record delle sorgenti e le modifiche ai consensi. Da questa base comune si possono ricavare viste differenti, ciascuna con i dati e le autorizzazioni adatti all'applicazione che la utilizza. Anche un sistema di personalizzazione può così ricevere comportamenti e preferenze senza ottenere automaticamente accesso a dati sensibili di fatturazione o a conversazioni private con l'assistenza.
Gli eventi raccontano che cosa è accaduto
Gli eventi descrivono i cambiamenti e le azioni che avvengono nel tempo: una registrazione, un accesso, l'apertura di un ticket, l'utilizzo di una funzione, un pagamento non riuscito o la modifica di una preferenza di consenso. Questa prospettiva è importante per l'IA perché permette di interpretare uno stato alla luce di ciò che è accaduto di recente. Un cliente può risultare attivo nel CRM e aver comunque aperto cinque ticket, interrotto l'uso di una funzione importante e registrato due pagamenti non riusciti nell'ultima settimana.
Per utilizzare questi segnali in modo affidabile occorre governarne il significato. I nomi degli eventi e le proprietà possono cambiare tra versioni del prodotto, team o sistemi: un'applicazione può inviare plan_name mentre un'altra utilizza subscription_plan per lo stesso concetto. La stessa azione può inoltre essere tracciata più volte, oppure un campo inizialmente facoltativo può diventare necessario alla logica che costruisce il profilo.
Gli eventi rilevanti dovrebbero quindi avere nomi comprensibili, informazioni sulla sorgente, timestamp, campi obbligatori e una validazione adeguata dello schema. Occorre poter riconoscere dati malformati, distinguere le versioni dello schema e rielaborare gli eventi quando cambia il modo in cui vengono interpretati. La qualità di questa raccolta influisce sia sulle analisi sia sul contesto che l'applicazione utilizza per comprendere la situazione del cliente.
I record descrivono la situazione attuale
Accanto agli eventi ci sono i record mantenuti dai sistemi operativi. Il CRM conserva informazioni sul responsabile dell'account, sulle opportunità e sulla relazione commerciale; la fatturazione gestisce abbonamenti, piani, rinnovi e pagamenti; l'assistenza registra ticket, priorità, escalation e stato degli SLA. Anche i sistemi di gestione dei consensi contribuiscono con preferenze e finalità autorizzate o revocate.
Questi record rappresentano spesso lo stato attuale del cliente, mentre gli eventi aiutano a comprendere come si sia arrivati a quello stato. Conoscere il piano attivo o la data di rinnovo risponde a un'esigenza diversa dal ricostruire una sequenza di errori di accesso o un calo nell'utilizzo del prodotto. Entrambe le prospettive possono servire durante una conversazione o una valutazione commerciale.
Il profilo dovrebbe combinarle mantenendo chiara la distinzione tra un fatto storico e una condizione attuale. Sapere che un abbonamento è stato disdetto, per esempio, non equivale a conoscere quando termini l'accesso al servizio. La provenienza, il significato dei campi e i rispettivi aggiornamenti permettono all'applicazione di utilizzare eventi e record senza trattarli come informazioni intercambiabili.
Dagli eventi grezzi ai segnali sul cliente
Per molte applicazioni è utile trasformare gli eventi e i record in stati, riepiloghi, metriche e segnali comprensibili. Un assistente per il supporto può lavorare sul numero di ticket aperti, sulla gravità del problema più recente, sulla presenza di un'escalation e sulla data dell'ultima interazione. In ambito commerciale possono essere più utili lo stato dell'abbonamento, il rinnovo, le fatture insolute e i segnali di rischio legati ai pagamenti.
Queste informazioni derivate devono restare collegabili ai dati originali, che servono per indagini, analisi, verifiche e ricostruzioni del profilo. Il significato di una metrica, il periodo che considera e la logica con cui viene calcolata dovrebbero essere definiti prima che quella metrica venga utilizzata in un processo automatizzato.
Se ogni richiesta richiede al modello di interpretare da capo tutti i dati grezzi, una parte della progettazione dei dati viene affidata all'applicazione IA. Preparare segnali e viste coerenti permette invece di definire quella logica in un punto in cui possa essere verificata, governata e riutilizzata. La quantità di contesto da fornire va quindi scelta in funzione del compito, anche quando il modello sarebbe tecnicamente in grado di elaborarne molto di più.
L'identity resolution è centrale
La stessa persona può comparire come visitatore anonimo, utente in prova, contatto del CRM, cliente della fatturazione, richiedente assistenza e iscritto alle comunicazioni marketing. Può utilizzare email diverse, appartenere a più workspace o cambiare azienda. Collegare queste rappresentazioni richiede regole che distinguano l'identità della persona dalle relazioni che ha con account e organizzazioni.
In Krenalis, un'identità rappresenta ciò che una specifica pipeline raccoglie su un utente da una sorgente. È un record che può contenere più identificatori e attributi, come un ID utente, un indirizzo email, un nome o informazioni sull'account. Un identificatore è invece uno dei valori utilizzabili per riconoscere o collegare quelle rappresentazioni: un indirizzo email, un ID del CRM e un ID della fatturazione non costituiscono automaticamente tre identità distinte.
Il profilo unificato deriva dalla riconciliazione delle identità correlate secondo le regole definite. Le informazioni raccolte dal CRM e dalla fatturazione, per esempio, possono contribuire allo stesso profilo pur mantenendo il riferimento alle rispettive pipeline. Conservare questa distinzione permette di capire quali record abbiano contribuito al risultato e di ricalcolarlo quando cambiano i dati o le regole di unificazione.
Negli scenari B2B occorre anche rappresentare correttamente aziende, entità giuridiche, account, workspace e ruoli delle persone coinvolte. Due utenti possono appartenere alla stessa organizzazione senza essere la stessa persona. Un dominio aziendale può essere utile per ricostruire una relazione con un'azienda, ma non è sufficiente, da solo, per identificare un individuo. Queste differenze devono rimanere visibili nel modello utilizzato dall'applicazione.
La spiegabilità conta più della sofisticazione dell'abbinamento
Gli approcci all'identity resolution possono utilizzare metodi diversi. Alcuni confrontano in modo deterministico identificatori e valori configurati; altri stimano una corrispondenza sulla base di nomi, indirizzi, dispositivi, comportamenti o ulteriori attributi. Quando il profilo viene usato in un processo operativo, oltre al risultato conta la possibilità di comprendere perché due record siano stati collegati e di riconoscere i limiti di quella corrispondenza.
Con identificatori affidabili, regole deterministiche esplicite offrono una base verificabile. Possono utilizzare un ID interno condiviso, un collegamento stabilito durante un accesso verificato o una mappatura tra CRM e fatturazione. Anche la scelta degli identificatori richiede però attenzione: un'email condivisa o riassegnata può produrre un collegamento errato pur rispettando formalmente la regola configurata.
Un errore di unificazione può portare un'applicazione ad attribuire a una persona la cronologia, le autorizzazioni o le informazioni di un'altra. Per questo deve essere possibile ricostruire il percorso seguito: quali identità sono state collegate, attraverso quali valori e con quali regole. In Krenalis, gli identificatori selezionati e le loro priorità determinano le corrispondenze e possono essere rivisti quando le esigenze o la qualità dei dati cambiano.
In altre architetture l'abbinamento probabilistico può avere un ruolo, per esempio nel suggerire collegamenti da riesaminare o in utilizzi con conseguenze più contenute. In questi casi l'applicazione dovrebbe poter distinguere le relazioni verificate dalle ipotesi, dalle corrispondenze probabili e da quelle ancora da valutare. Un risultato plausibile non dovrebbe assumere automaticamente lo stesso valore operativo di un collegamento verificato.
I profili devono poter essere ricostruiti
Le regole di unificazione possono evolvere insieme ai sistemi aziendali. Un'organizzazione può sostituire il CRM, introdurre un nuovo servizio di fatturazione, modificare la gerarchia degli account o decidere che indirizzi condivisi come support@, admin@ e accounting@ non siano adatti a riconoscere un individuo. Per applicare questi cambiamenti occorre poter ricalcolare i profili dai dati che li hanno generati.
Se rimane soltanto il profilo finale e i record originali sono stati appiattiti o eliminati, diventa difficile correggere un'unificazione errata e capire a quale sorgente appartenesse ciascuna informazione. Conservare le identità, i record sorgente, gli eventi e le regole applicate permette invece di riesaminare la costruzione del profilo e adattarla a nuove esigenze.
In Krenalis l'identity resolution è reversibile: gli identificatori e le priorità possono essere modificati e l'elaborazione può essere eseguita nuovamente senza perdere i dati sottostanti. Il profilo va quindi considerato una rappresentazione derivata, che può cambiare mentre migliorano la qualità dei dati e la comprensione della relazione con il cliente.
Il consenso fa parte del profilo
Consensi, finalità e autorizzazioni devono essere considerati quando si progetta il profilo e il modo in cui viene reso disponibile. Le informazioni necessarie a risolvere una richiesta di assistenza possono non essere utilizzabili per attribuire un punteggio commerciale alla stessa persona. Allo stesso modo, un sistema di personalizzazione può avere bisogno dei comportamenti nel prodotto senza dover accedere a conversazioni private o a dati sensibili dell'assistenza.
Una piattaforma di gestione dei consensi può restare il sistema che raccoglie e mantiene le preferenze. La base dati dei clienti deve però ricevere gli aggiornamenti necessari e utilizzarli per costruire le viste rivolte alle applicazioni. A seconda dell'architettura, questo può richiedere informazioni sui consensi attivi o revocati, sulle date e sulle sorgenti di raccolta, sulle finalità consentite e sulle categorie di dati escluse.
Anche l'uso operativo dei dati e il loro eventuale impiego per addestrare un modello richiedono valutazioni distinte. L'accesso a un'informazione per una determinata interazione non deve essere interpretato automaticamente come autorizzazione a qualsiasi utilizzo successivo. Definire questi confini aiuta a evitare che preferenze correttamente registrate in un sistema vengano ignorate durante la preparazione del contesto fornito all'IA.
Mantieni il profilo dove puoi governarlo
La collocazione del profilo è una scelta architetturale. Per molte aziende il warehouse o il lakehouse costituiscono un punto di riferimento naturale perché raccolgono già dati di CRM, fatturazione, assistenza, prodotto e modelli interni. Costruire lì i profili può renderli accessibili ai team che devono esaminarli, verificarli e riutilizzarli, insieme agli altri dati aziendali.
Quando il profilo esiste soltanto nella piattaforma di un fornitore, occorre valutare quali possibilità rimangano per accedere ai dati sottostanti, comprenderne la provenienza, verificare i collegamenti e ricostruire il risultato. Il controllo dipende sia dall'accessibilità delle informazioni sia dalla possibilità di intervenire sul modello che le rappresenta.
Questa scelta non obbliga ogni applicazione a interrogare direttamente il warehouse durante una conversazione. Un sistema in produzione può utilizzare API interne, cache, servizi di recupero delle informazioni, livelli semantici o archivi operativi. È importante mantenere chiaro il rapporto tra queste modalità di accesso e il profilo di riferimento, che deve poter essere esaminato e governato nell'architettura dell'azienda.
Un'unica base, viste diverse
Un profilo unificato può raccogliere informazioni utili a molti team e risultare comunque troppo ampio per una singola applicazione IA. Le viste dedicate permettono di selezionare il contesto adatto a ciascuna finalità, applicando i controlli di accesso previsti e rendendo più semplice comprendere quali dati stia utilizzando l'applicazione.
Per il supporto possono servire identità, piano attuale, funzionalità incluse, ticket aperti e interazioni recenti. Un assistente commerciale può avere bisogno dello stato delle opportunità, del rinnovo, dei segnali di adozione, delle possibilità di espansione e di un riepilogo dei rischi legati all'assistenza. La personalizzazione può invece utilizzare comportamenti, preferenze, fase del ciclo di vita e requisiti di accesso, insieme ai consensi e alle esclusioni pertinenti.
Tutte queste viste possono derivare dalla stessa base dati mantenendo selezioni e regole differenti. Questo facilita anche la valutazione dei sistemi IA: quando il contesto è definito per uno scopo preciso, è più semplice controllare che contenga le informazioni necessarie, individuare quelle mancanti e verificare che non esponga dati estranei al compito.
L'aggiornamento dipende dal caso d'uso
La frequenza di aggiornamento deve essere commisurata all'utilizzo del profilo. Un report settimanale può funzionare con aggiornamenti giornalieri, mentre un assistente alla pianificazione commerciale può tollerare un certo ritardo se il quadro complessivo è accurato e completo. Un assistente al servizio clienti può invece dover conoscere un ticket critico aperto pochi minuti prima, e un processo di fidelizzazione può richiedere una reazione rapida a un segnale di disdetta.
Per valutare questi requisiti occorre osservare l'intero percorso. Un evento può raggiungere il warehouse in pochi secondi, mentre il profilo unificato viene ricalcolato ogni sei ore. In quel caso la raccolta è rapida, ma il contesto utilizzato dall'applicazione può essere ancora precedente all'evento. Può verificarsi anche la situazione opposta: il profilo viene aggiornato rapidamente, mentre una cache continua a fornire una versione obsoleta.
La misura rilevante è quindi il tempo necessario perché un cambiamento alla sorgente raggiunga la vista effettivamente utilizzata dall'IA. Questo comprende acquisizione, identity resolution, calcolo degli attributi, aggiornamento delle viste e accesso da parte dell'applicazione. Anche la propagazione di una revoca del consenso deve essere valutata lungo questa catena quando modifica le informazioni che possono essere utilizzate.
Che cosa verificare prima di costruire
Prima di scegliere una piattaforma o progettare le integrazioni conviene verificare dove risiederanno i profili, chi potrà interrogarli e come sarà possibile esaminarne la costruzione. Il sistema dovrebbe mostrare quali record delle sorgenti abbiano contribuito a ciascun profilo, con i relativi identificatori e attributi, senza confondere il record che rappresenta un utente con un singolo valore utilizzato per riconoscerlo.
Occorre poi capire come funzionino le regole di corrispondenza, quali collegamenti siano verificati o richiedano una revisione e come si corregga un errore. La possibilità di rielaborare i dati originali diventa importante quando cambiano gli identificatori, le priorità o il modo in cui vengono rappresentati utenti e organizzazioni.
La verifica deve comprendere anche gli utilizzi consentiti e il servizio fornito alle applicazioni: come si propagano i cambiamenti ai consensi, quali campi siano disponibili nelle diverse viste e con quale ritardo arrivino gli aggiornamenti. Queste domande permettono di valutare il profilo come parte di un processo operativo, oltre alle singole funzionalità offerte dal CDP.
Il CDP non può restare soltanto un livello di attivazione
I CDP continuano a offrire valore quando raccolgono dati, unificano profili, creano segmenti e sincronizzano audience con altri strumenti. Se devono fornire anche il contesto utilizzato dall'IA, la valutazione deve però estendersi al modo in cui collegano i dati, ne rendono comprensibile la provenienza e ne controllano l'accesso.
Una piattaforma adatta a questo ruolo dovrebbe conservare il rapporto tra le identità e le sorgenti, rendere spiegabili le corrispondenze, consentire la ricostruzione dei profili e supportare viste differenti per applicazioni con finalità diverse. L'attivazione rimane una parte del lavoro, inserita in un'architettura che definisce anche come il cliente venga rappresentato prima che un sistema automatizzato utilizzi le sue informazioni.
Il profilo è un prodotto
Trattare il profilo cliente come un prodotto aiuta a chiarire le responsabilità necessarie per mantenerlo affidabile. Servono un responsabile, definizioni documentate dei campi, standard di qualità, regole di accesso e controlli sul funzionamento nel tempo. Un profilo destinato a essere utilizzato da più applicazioni richiede una gestione che vada oltre la configurazione iniziale delle integrazioni.
Qualcuno deve decidere quali sorgenti siano attendibili, come gestire valori in conflitto e quali segnali abbiano un significato operativo. Occorre inoltre stabilire come misurare l'aggiornamento dei dati, correggere gli errori e propagare le modifiche ai consensi. Quando cambia la logica del profilo, vanno considerati anche gli effetti sulle applicazioni che lo utilizzano.
Senza questa responsabilità i campi tendono ad accumularsi, le regole diventano difficili da ricostruire e le viste progettate per uno scopo possono essere riutilizzate altrove senza verificarne l'adeguatezza. Documentazione e monitoraggio permettono di riconoscere questi cambiamenti prima che diventino problemi visibili nelle interazioni con i clienti.
Il contratto sui dati alla base dell'IA
Quando il profilo e le sue viste sono definiti con chiarezza, l'applicazione riceve un input più comprensibile. L'assistente per il supporto può recuperare il contesto necessario all'assistenza, quello commerciale può lavorare su segnali documentati dell'account e il sistema di personalizzazione può utilizzare una selezione che tenga già conto di preferenze, requisiti e regole di accesso.
In senso tecnico, questo rapporto può essere descritto come un contratto sui dati: un accordo sul significato dei campi, sulle sorgenti utilizzate, sulle relazioni di identità, sui tempi di aggiornamento e sui limiti di utilizzo. Definire queste condizioni riduce il lavoro che ogni applicazione deve svolgere per interpretare autonomamente informazioni raccolte per scopi differenti.
Rimangono comunque necessari la valutazione delle risposte, la sicurezza, la progettazione dei prompt, i controlli di protezione e il monitoraggio dei modelli. Un contesto ben governato fornisce una base più chiara a queste verifiche, ma deve essere considerato insieme al comportamento dell'applicazione e del modello che lo utilizzano.
Quale tipo di CDP può supportare questo modello?
Le organizzazioni possono costruire queste capacità intorno al proprio warehouse o lakehouse, utilizzare un CDP oppure combinare l'infrastruttura dati con servizi dedicati. La scelta dipende dai sistemi disponibili e dalle competenze del team; in ogni caso occorre valutare come vengano raccolti, collegati, governati e resi accessibili i dati.
Le proprietà da ricercare sono quelle descritte lungo l'articolo: dati tracciabili, identità spiegabili, profili ricostruibili e viste coerenti con le finalità delle applicazioni. Un CDP progettato soprattutto per campagne e audience può contribuire a questa architettura, ma va verificato rispetto alle esigenze operative della Customer AI e al controllo che consente di mantenere sulla rappresentazione del cliente.
Il prossimo passo
Questo è il secondo capitolo di una serie di tre articoli sulla Customer AI. Il capitolo successivo, Il CDP è nato per le campagne. L'IA ha bisogno di una memoria del cliente, approfondisce come cambia il ruolo del CDP quando il profilo cliente diventa una base per l'intelligenza artificiale.